Générateur de vidéo de personnage IA : comment garder le même personnage dans chaque clip
Pourquoi les personnages dérivent dans les vidéos IA, et quatre façons de garder le même personnage dans chaque clip : mode scénario, référence-vers-vidéo, un seul portrait, et photos parlantes.
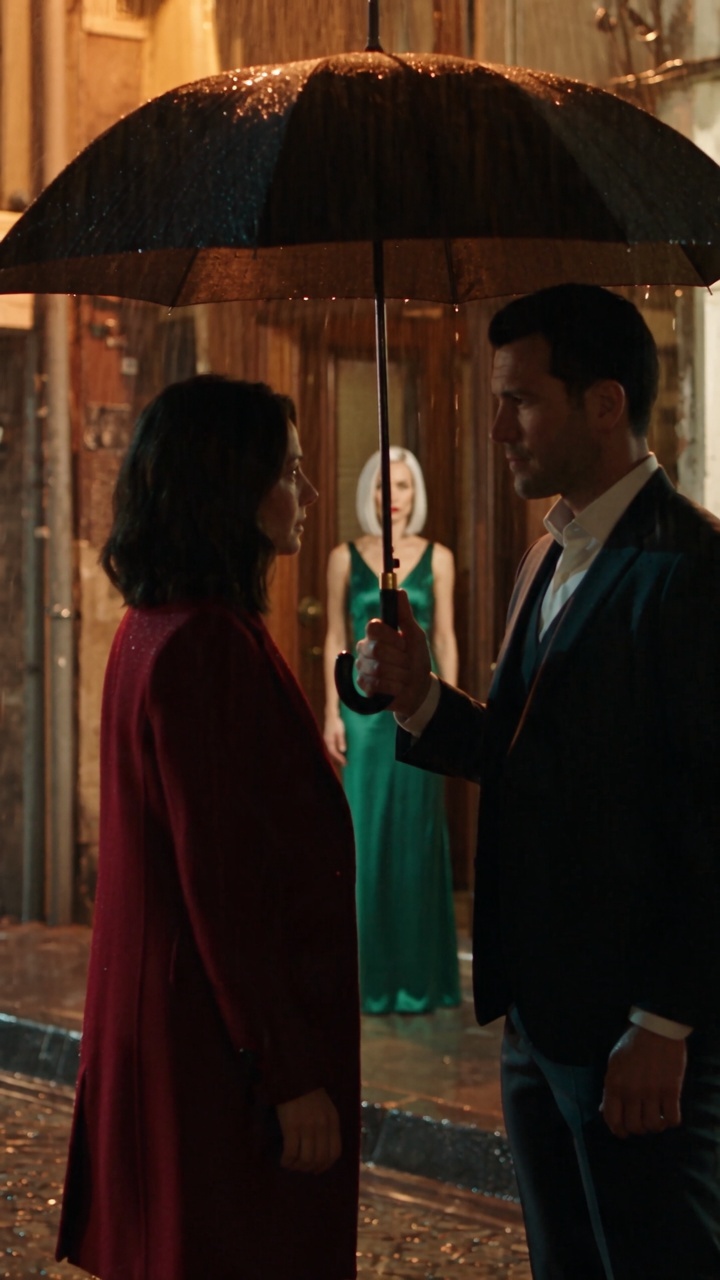
La chose la plus difficile en vidéo IA n'est pas de réussir un bon clip. C'est de réussir le deuxième clip avec la même personne dedans. Générez deux fois à partir de la même description et vous obtenez généralement deux personnes différentes.
Ce guide explique pourquoi cela arrive et les quatre méthodes par lesquelles Reelina maintient un personnage cohérent — avec les modèles et les prix de notre catalogue à jour en octobre 2026.
Pourquoi les personnages dérivent
Aucun modèle vidéo ne se souvient de qui que ce soit. Chaque génération repart de zéro : elle lit votre prompt et les images que vous lui fournissez, et rien n'est conservé pour la génération suivante. Rien n'est entraîné sur votre personnage chez Reelina.
La cohérence a donc exactement une seule source : fournir au modèle les mêmes références à chaque fois. Chaque méthode ci-dessous est une manière de bien faire cela.
1. Laissez le mode scénario distribuer vos personnages
Le générateur de drames IA gère l'ensemble du processus pour une scène à plusieurs plans :
- Vous écrivez la scène en mots simples.
- Le planificateur la découpe en plans et liste les personnages nécessaires. Vous voyez le plan et le prix avant que quoi que ce soit ne soit généré.
- Chaque personnage est d'abord dessiné sous forme de portrait de référence, et ce portrait est fourni au premier plan.
- Chaque plan suivant repart de la dernière image du plan précédent, de sorte que les visages, les vêtements et la lumière se transmettent sans saut de caméra.
Les dialogues peuvent être prononcés dans la langue de votre choix. C'est la manière la plus simple d'obtenir plusieurs plans avec les mêmes personnes.
2. Utilisez un modèle référence-vers-vidéo avec votre propre personnage
Si vous avez déjà votre personnage — une photo, une illustration, une mascotte de produit — utilisez un modèle conçu pour exploiter des références :
| Modèle | Coins | Ce qu'il accepte |
|---|---|---|
| Seedance 2.0 Mini Reference-to-Video | 68 | Jusqu'à 9 images, 3 vidéos, audio de référence |
| Seedance 2.0 Reference-to-Video | 136 | Jusqu'à 9 images, 3 vidéos, audio de référence |
| Seedance 2.5 Reference-to-Video | 204 | Jusqu'à 30 images, 10 vidéos, audio de référence |
| Vidu Q2 Reference-to-Video | 96 | 1 à 7 sujets |
| Kling Video O3 Std Reference-to-Video | 108 | « Éléments » de sujet |
| Wan 2.7 Reference-to-Video | 152 | Jusqu'à 3 vidéos, une par personnage, qui peut porter sa propre voix |
Donnez à chaque personnage sa propre image, et fournissez les mêmes images à chaque plan. La liste complète des 26 modèles se trouve dans notre guide reference-to-video.
3. Animez un seul portrait, plan après plan
La méthode la plus simple : gardez un bon portrait et utilisez-le comme image de départ pour l'image-vers-vidéo à chaque fois — sur Kling 3.0, Seedance 2.0 ou tout autre modèle image-vers-vidéo. Chaque clip commence exactement avec votre personnage.
4. Faites parler ou bouger le personnage sur commande
- Parler : l'application Talking Photo fait parler la personne d'un portrait — tapez le texte ou chargez une voix.
- Bouger : Motion Control récupère le mouvement d'une vidéo de référence et l'applique au personnage de votre image.
Comment écrire un personnage qui reste le même
- Décrivez précisément. « Une femme » donne une femme différente chaque fois. « Une femme de 28 ans, cheveux châtain foncé mi-longs, yeux noisette, manteau en laine rouge » donne toujours la même.
- Créez une référence propre. Corps entier ou cadrage tête-et-épaules, fond neutre, visage vers la caméra, lumière uniforme. Une lumière dramatique dans la référence se retrouve dans chaque scène.
- Gardez un casting restreint. Deux ou trois personnages principaux restent reconnaissables ; les foules dérivent.
- Ne transmettez que les personnages présents dans le plan. Des références superflues placent des personnes là où elles n'ont rien à faire.
FAQ
L'IA peut-elle garder le même personnage d'une vidéo à l'autre ? Oui, en fournissant à chaque génération la même image ou les mêmes images de référence. Le modèle ne se souvient pas du personnage entre les générations ; ce sont les références qui le transportent.
Quel est le meilleur générateur de vidéo de personnage IA ? Pour une scène complète, un outil qui distribue des portraits de référence et enchaîne les plans — le générateur de drames IA de Reelina fait les deux. Pour des plans isolés avec votre propre personnage, un modèle référence-vers-vidéo comme Seedance 2.0 (jusqu'à 9 images de référence).
Entraîne-t-on quelque chose sur le visage de mon personnage ? Non. Les références ne sont utilisées que pour cette génération. Rien n'est entraîné ni stocké sous forme de modèle.
Ai-je besoin d'une clé API ou d'un abonnement séparé ? Non. Chaque modèle fonctionne dans le navigateur à partir d'un seul solde de coins Reelina. Il n'y a pas d'offre gratuite ; le coût exact est affiché avant chaque génération.
Try it yourself
Every model on one credit balance, straight in your browser. No install, no watermark.
Start creatingKeep reading
 Lip Sync IA : comment faire dire de nouveaux mots à une vidéo (ou une photo)Le lip sync IA, deux approches : redoubler une vidéo existante ou faire parler une photo. Les applications, les modèles, leurs prix en pièces, et ce qui rend le résultat crédible.
 Référence vers Vidéo IA : Chaque Modèle, Ses Limites et Son PrixL'IA référence-vers-vidéo garde vos personnages, produits et voix dans un nouveau plan. Tous les modèles disponibles sur Reelina, le nombre de références acceptées et leur prix.
 Seedance 2.0 contre Kling 3.0 : spécifications, prix et quand utiliser chacunSeedance 2.0 contre Kling 3.0 : formules, durée des clips, formats d'image, audio, référence-vers-vidéo contre plans multiples et contrôle du mouvement, et coût à la seconde en pièces.