Generator wideo z postaciami AI: jak zachować tę samą postać w każdym klipie
Dlaczego postacie w wideo AI się zmieniają i cztery sposoby, by zachować tę samą postać w każdym klipie: tryb fabularny, reference-to-video, jeden portret i mówiące zdjęcia.
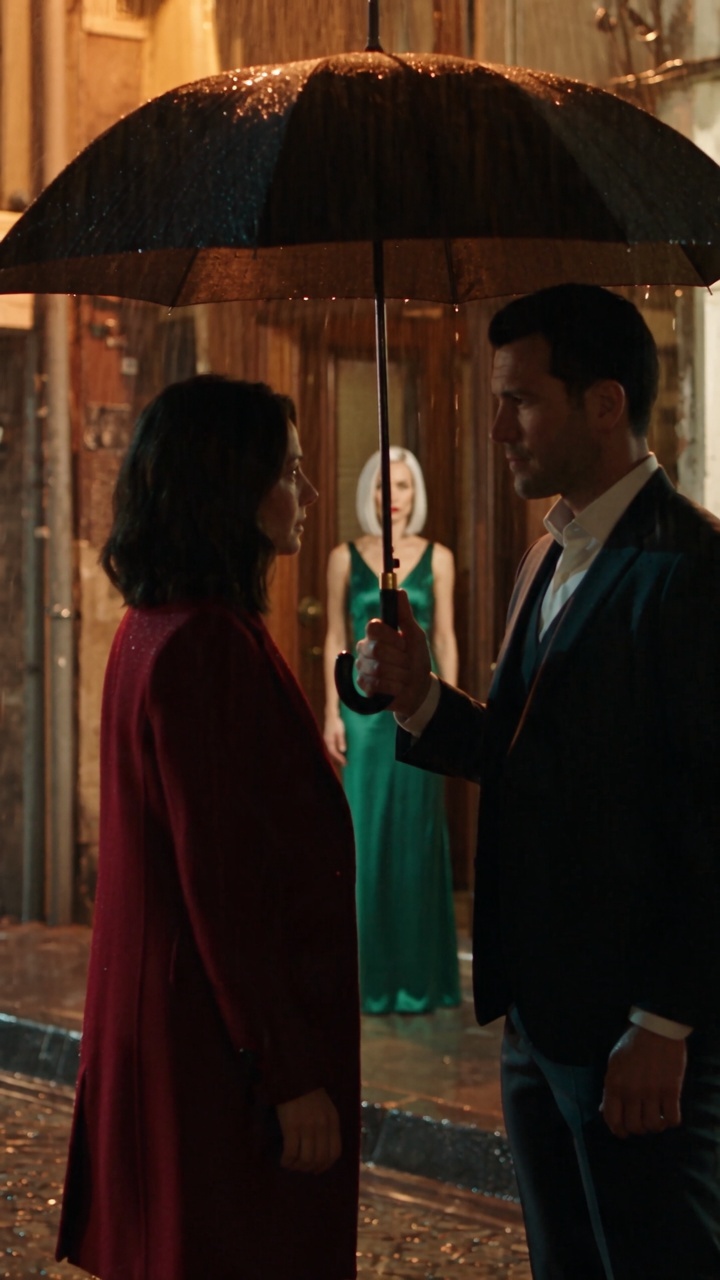
Najtrudniejszą rzeczą w wideo AI nie jest zrobienie jednego dobrego klipu. Jest nią zrobienie drugiego klipu z tą samą osobą. Wygeneruj dwa razy na podstawie tego samego opisu i zwykle dostaniesz dwie różne osoby.
Ten przewodnik wyjaśnia, czemu tak się dzieje, oraz cztery sposoby, w jaki Reelina zachowuje spójność postaci — z modelami i cenami z naszego katalogu na październik 2026.
Czemu postacie się zmieniają
Żaden model wideo nikogo nie pamięta. Każda generacja zaczyna się od zera: model odczytuje twój prompt i obrazy, które mu podasz, a nic nie przechodzi do następnego uruchomienia. W Reelinie nic nie jest trenowane na twojej postaci.
Dlatego spójność ma tylko jedno źródło: podawanie modelowi tych samych materiałów referencyjnych każdym razem. Każda z poniższych metod to sposób, by robić to dobrze.
1. Pozwól trybowi fabularnemu obsadzić twoje postacie
Generator dramatów AI obsługuje cały proces dla scen złożonych z wielu ujęć:
- Piszesz scenę zwykłymi słowami.
- Planer dzieli ją na ujęcia i wypisuje potrzebne postacie. Widzisz plan i cenę, zanim cokolwiek zostanie wygenerowane.
- Każda postać jest najpierw rysowana jako portret referencyjny, który trafia do pierwszego ujęcia.
- Każde następne ujęcie zaczyna się od ostatniej klatki poprzedniego, dzięki czemu twarze, ubrania i światło przechodzą dalej bez skoków kamery.
Dialogi mogą być wypowiadane w wybranym przez ciebie języku. To najprostszy sposób, by uzyskać kilka ujęć z tymi samymi osobami.
2. Użyj modelu reference-to-video z własną postacią
Jeśli masz już swoją postać — zdjęcie, ilustrację, maskotkę produktu — użyj modelu zbudowanego do przyjmowania materiałów referencyjnych:
| Model | Monety | Co przyjmuje |
|---|---|---|
| Seedance 2.0 Mini Reference-to-Video | 68 | Do 9 obrazów, 3 filmy, dźwięk referencyjny |
| Seedance 2.0 Reference-to-Video | 136 | Do 9 obrazów, 3 filmy, dźwięk referencyjny |
| Seedance 2.5 Reference-to-Video | 204 | Do 30 obrazów, 10 filmów, dźwięk referencyjny |
| Vidu Q2 Reference-to-Video | 96 | 1–7 podmiotów |
| Kling Video O3 Std Reference-to-Video | 108 | „Elementy” podmiotu |
| Wan 2.7 Reference-to-Video | 152 | Do 3 filmów, jeden na postać, każdy może nieść jej głos |
Daj każdej postaci jej własny obraz i podawaj te same obrazy do każdego ujęcia. Pełna lista 26 modeli znajduje się w naszym przewodniku po reference-to-video.
3. Animuj jeden portret, ujęcie po ujęciu
Najprostsza metoda: zachowaj jeden dobry portret i każdym razem używaj go jako klatki startowej dla image-to-video — w Kling 3.0, Seedance 2.0 lub w jakimkolwiek innym modelu image-to-video. Każdy klip zaczyna się dokładnie od twojej postaci.
4. Spraw, by postać mówiła lub ruszała się na komendę
- Mówienie: aplikacja Talking Photo sprawia, że osoba na portrecie mówi — wpisz słowa albo wgraj głos.
- Ruch: Motion Control bierze ruch z wideo referencyjnego i stosuje go do postaci na twoim obrazie.
Jak opisać postać, która się nie zmienia
- Opisuj precyzyjnie. „Kobieta” daje każdym razem inną kobietę. „28-letnia kobieta, ciemnobrązowe włosy do ramion, piwne oczy, czerwony wełniany płaszcz” daje tę samą.
- Zrób czystą referencję. Cała postać albo głowa i ramiona, jednolite tło, twarz zwrócona do kamery, równomierne światło. Dramatyczne światło w referencji trafi do każdej sceny.
- Trzymaj obsadę małą. Dwie lub trzy główne postacie pozostają rozpoznawalne; tłumy się rozmywają.
- Podawaj tylko postacie, które są w ujęciu. Dodatkowe referencje umieszczają ludzi tam, gdzie nie powinni być.
FAQ
Czy AI może zachować tę samą postać we wszystkich filmach? Tak, podając każdej generacji ten sam obraz lub obrazy referencyjne. Model nie pamięta postaci między uruchomieniami — to referencje ją przenoszą.
Jaki jest najlepszy generator wideo z postaciami AI? Dla całej sceny — narzędzie, które obsadza portrety referencyjne i łączy ujęcia w ciąg; generator dramatów AI od Reeliny robi obie te rzeczy. Dla pojedynczych ujęć z własną postacią — model reference-to-video, taki jak Seedance 2.0 (do 9 obrazów referencyjnych).
Czy coś jest trenowane na twarzy mojej postaci? Nie. Materiały referencyjne są używane tylko do tej jednej generacji. Nic nie jest trenowane ani zapisywane jako model.
Czy potrzebuję klucza API lub osobnej subskrypcji? Nie. Każdy model działa w przeglądarce na jednym saldzie monet Reelina. Nie ma darmowego planu — dokładny koszt jest widoczny przed każdą generacją.
Try it yourself
Every model on one credit balance, straight in your browser. No install, no watermark.
Start creatingKeep reading
 Lip Sync AI: jak sprawić, by wideo (lub zdjęcie) powiedziało nowe słowaLip sync AI na dwa sposoby: podłożenie nowego głosu na wideo albo ożywienie zdjęcia mówieniem. Aplikacje, modele, ich ceny w coinach i co sprawia, że wynik wygląda realistycznie.
 Reference to Video AI: każdy model, jego limity i cenaAI typu reference-to-video zachowuje twoje postacie, produkty i głosy w nowym ujęciu. Wszystkie modele na Reelinie, liczba referencji dla każdego i ich ceny.
 Kling 3.0 vs Veo 3.1: długość klipów, dźwięk i kosztKling 3.0 vs Veo 3.1: klipy 3–15 s kontra 4, 6 lub 8 s, formaty obrazu, rozdzielczości, które warianty generują dźwięk oraz koszt za sekundę dla każdej opcji.